用户教程
从零启动并部署第一个模型
本文目录
适用场景:首次安装 GPUWorks,接入一台 GPU 节点并部署对话模型。
前置条件:下表所列的 Linux 主机、权限与网络;本教程不用于升级已有环境。
目标:通过 OpenAI 兼容接口调用 Qwen/Qwen3-1.7B,获得模型回答。
开始之前
如果这些主机已运行其他推理平台,或准备复用旧平台的 GPU,先按替换已有推理平台完成备份、停服以及端口和 GPU 占用检查,再开始本教程。安装命令不会自动接管旧平台。
| 你需要 | 说明 |
|---|---|
| 控制面主机 | Linux x86_64 + systemd;具备 Bash、curl、tar、sha256sum 和 sudo 权限。浏览器与 GPU 节点可访问其 8800 端口;控制面提供资源管理、Web 控制台和推理入口 |
| GPU 节点 | 实验专用的 Linux x86_64 + systemd 主机,未安装其他 GPUWorks agent;具备 curl、root 或免密 sudo,以及存放模型和镜像的本地磁盘 |
| GPU 与驱动 | 示例使用 GeForce RTX 4090(48 GiB),NVIDIA 驱动 ≥ 580,nvidia-smi 可识别 GPU;其他型号需确认与推荐模板兼容 |
| 运行环境 | 有可用 Docker 时使用 Docker,否则 agent 使用内置 runveil。驱动、GPU 与推理镜像须兼容,部署前检查配置评估 |
| 网络 | 控制面主机能下载 GPUWorks 发布包;控制面和节点能访问 ModelScope,节点能访问推理镜像仓库。离线场景改用离线环境部署 |
控制面和 GPU 节点可以同机,命令仍按下文指定的位置执行。模型、镜像的下载时间取决于网络与磁盘速度。 Mac 本地试用见在 Mac 上运行第一个本地模型;Linux 无 sudo 或非 systemd 环境见安装和升级控制面。
下文以 host3 为节点显示名称,无需修改操作系统主机名;模型、部署及令牌名称在对应步骤填写。
1. 启动 server
正式部署用安装命令(写 systemd 单元、后台常驻、默认目录 /opt/gpuworks/server):
./gpuworks install --addr 192.0.2.10:8800本文用 192.0.2.10 代表 server 主机的地址(文档专用的示例地址),操作时换成你自己主机的 IP。
发布包的下载和校验步骤见安装和升级控制面。只想先看一眼,也可以前台跑一个临时实例:
./gpuworks serve --addr :8800 --data ./data你应该看到:命令最后打印安装摘要,包含访问地址和 admin 初始密码;curl http://192.0.2.10:8800/healthz 返回 {"status":"ok",...}。
首次启动会创建 admin 账户,密码记录在数据目录的 initial-credentials(默认 0600,可信 Linux 平台组为 0660),安装摘要里也会打印一次。
浏览器打开 http://192.0.2.10:8800,用 admin 登录,改密后删除该文件。界面默认跟随浏览器语言,
右上角可以切换为中文。
2. 接入节点
左侧菜单进入“计算节点”,点击右上角“添加节点”。本教程用最通用的 curl 方式:把“目标机器是否支持 SSH”选为
“不支持 SSH”,“节点名称”填 host3,“连接方向”保持“Agent 发起连接”,“管理节点接入地址”预填的是浏览器当前访问的地址(也可以改成
域名或反代地址),然后点击“创建节点并生成命令”。
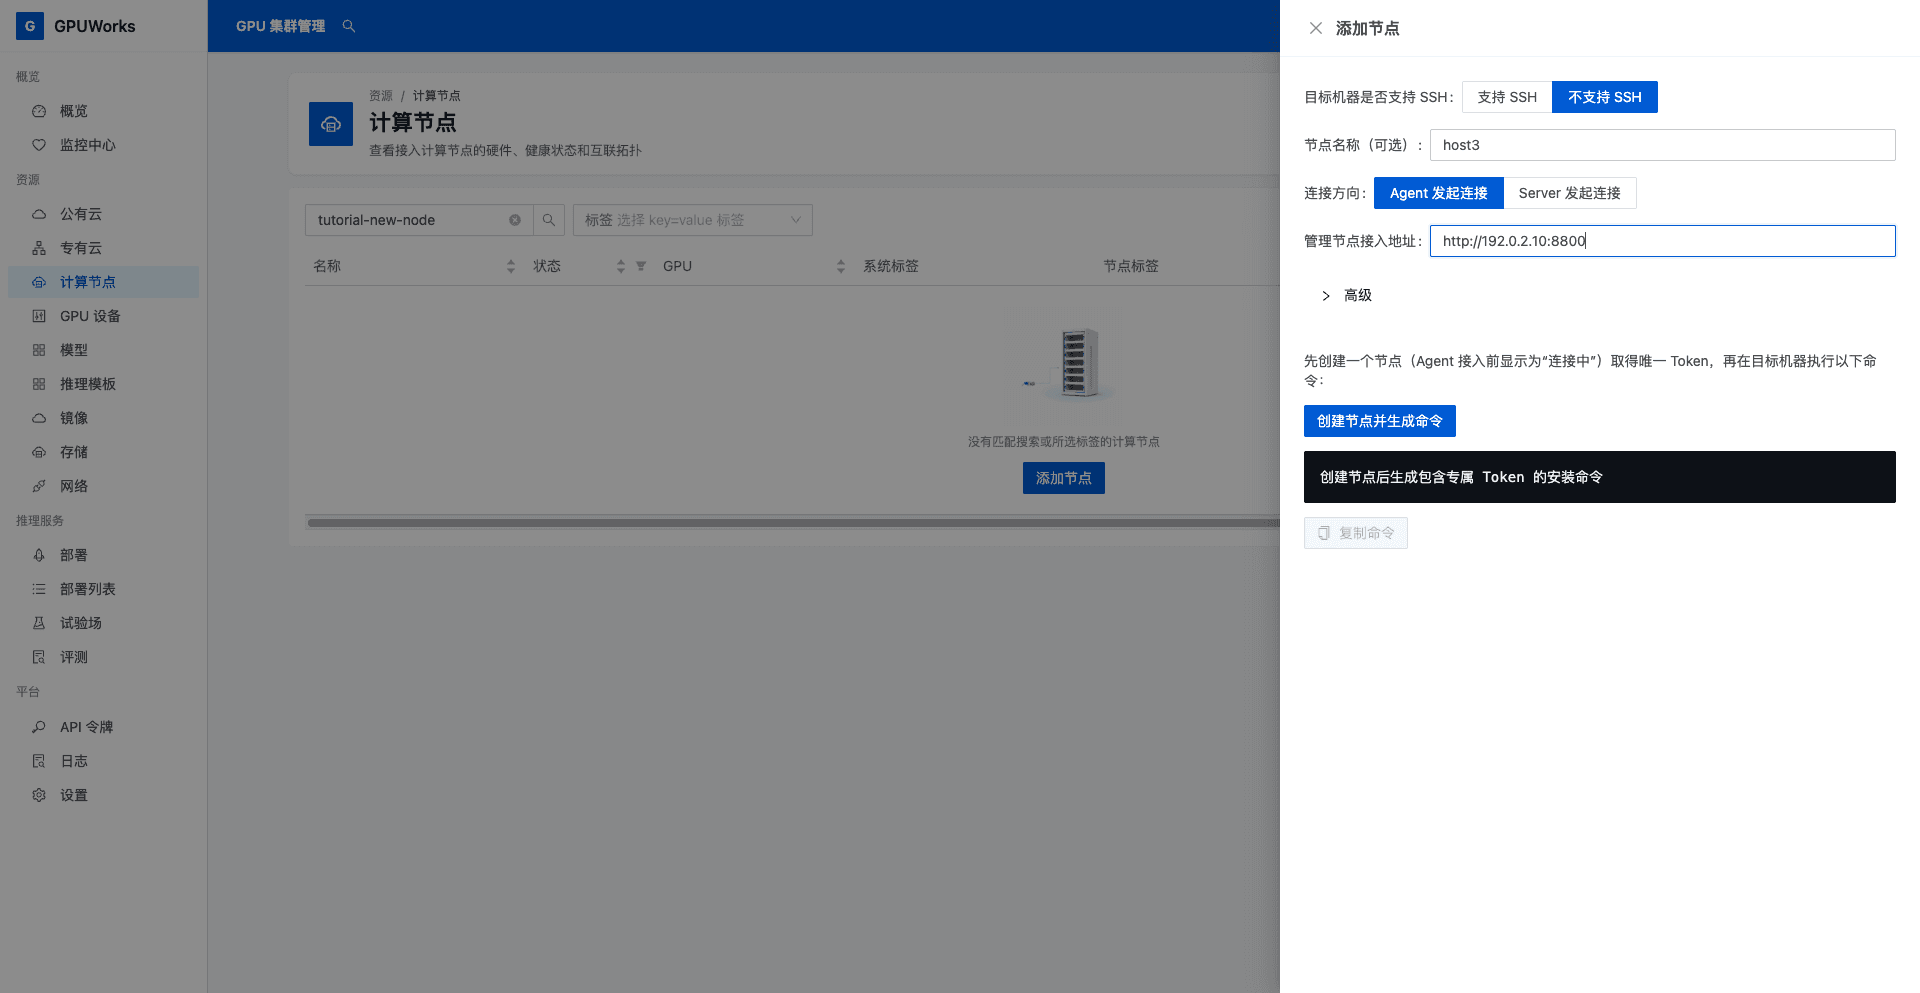
复制生成的命令,在 GPU 节点上执行(命令里已经带了这个节点专属的 token):
curl -fsSL http://192.0.2.10:8800/install.sh | sh -s -- \
  --server http://192.0.2.10:8800 --token <node-token>
默认 agent 主动外连 server,节点不需要开放入站端口。若节点无法出站连到 server、但 server 能直连节点的监听端口,改用 server_dial 接入指南。
你应该看到:回到“计算节点”页,几秒内状态变为“在线”,并显示 GPU 型号与数量、驱动版本、内存和 CPU; 点击行尾“详情”可以看到运行时(docker / runveil)、Agent 版本和网络地址等。
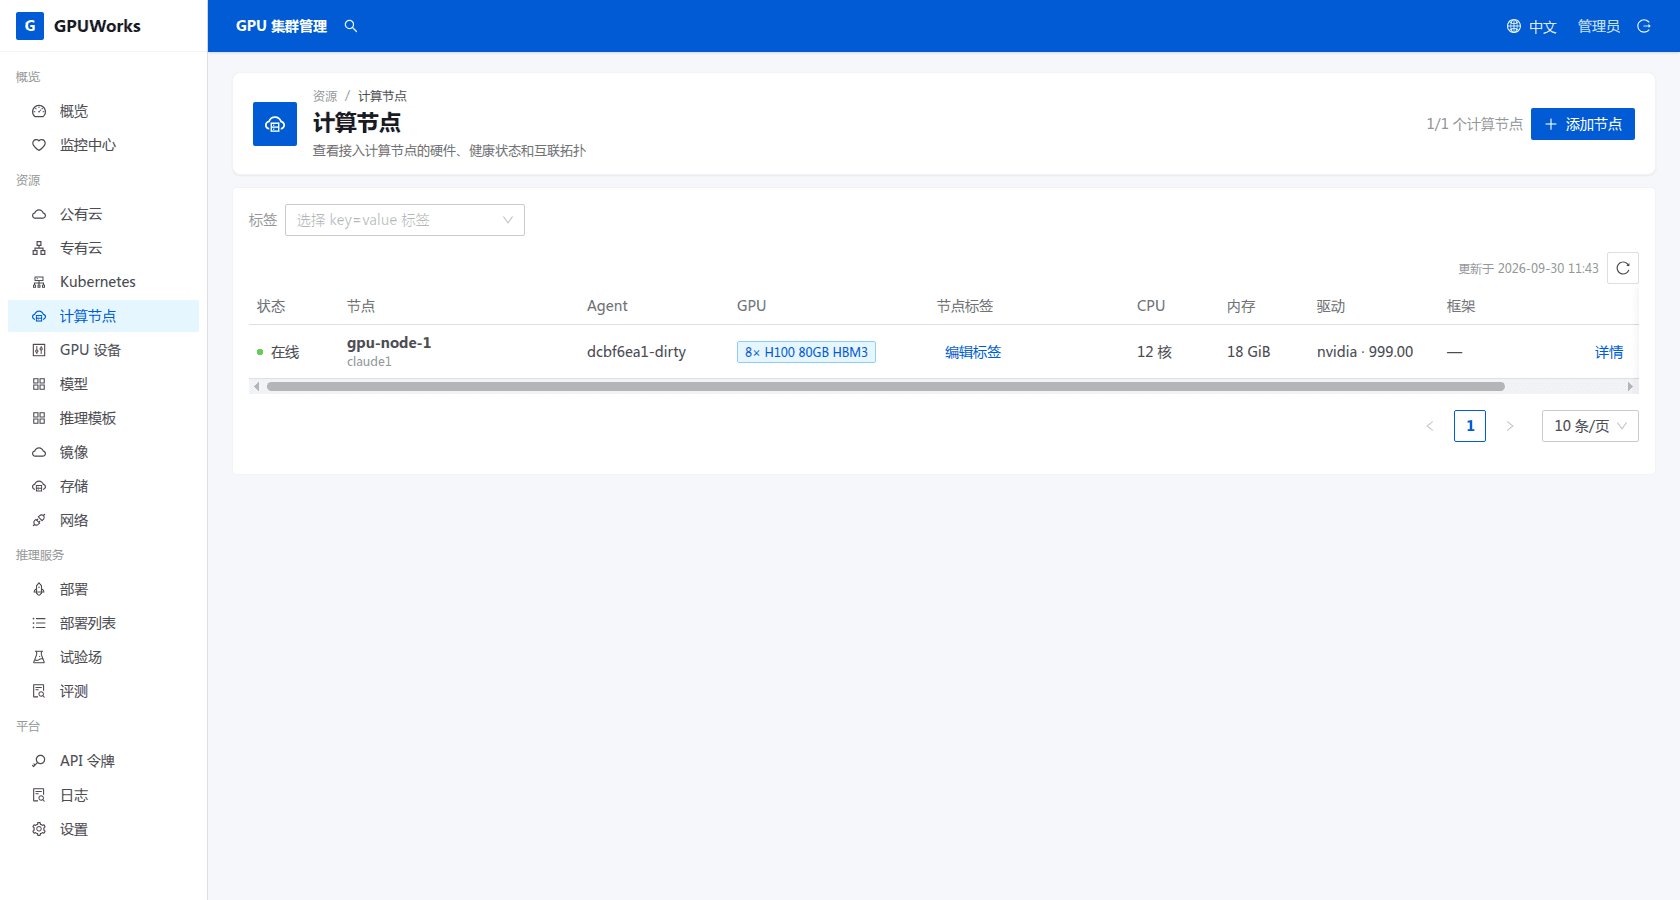
如果节点一直没有上线,见排障指南的“节点一直不上线”。
3. 注册并下载模型
注册模型
- 打开左侧模型,点击注册模型。
- 来源选择 ModelScope,来源 ID填写
Qwen/Qwen3-1.7B,名称填写dgpu-demo-a-ms。 高级选项 → 版本指定留空,使用默认分支。 - 点击确认注册,在模型列表中核对名称与来源 ID。
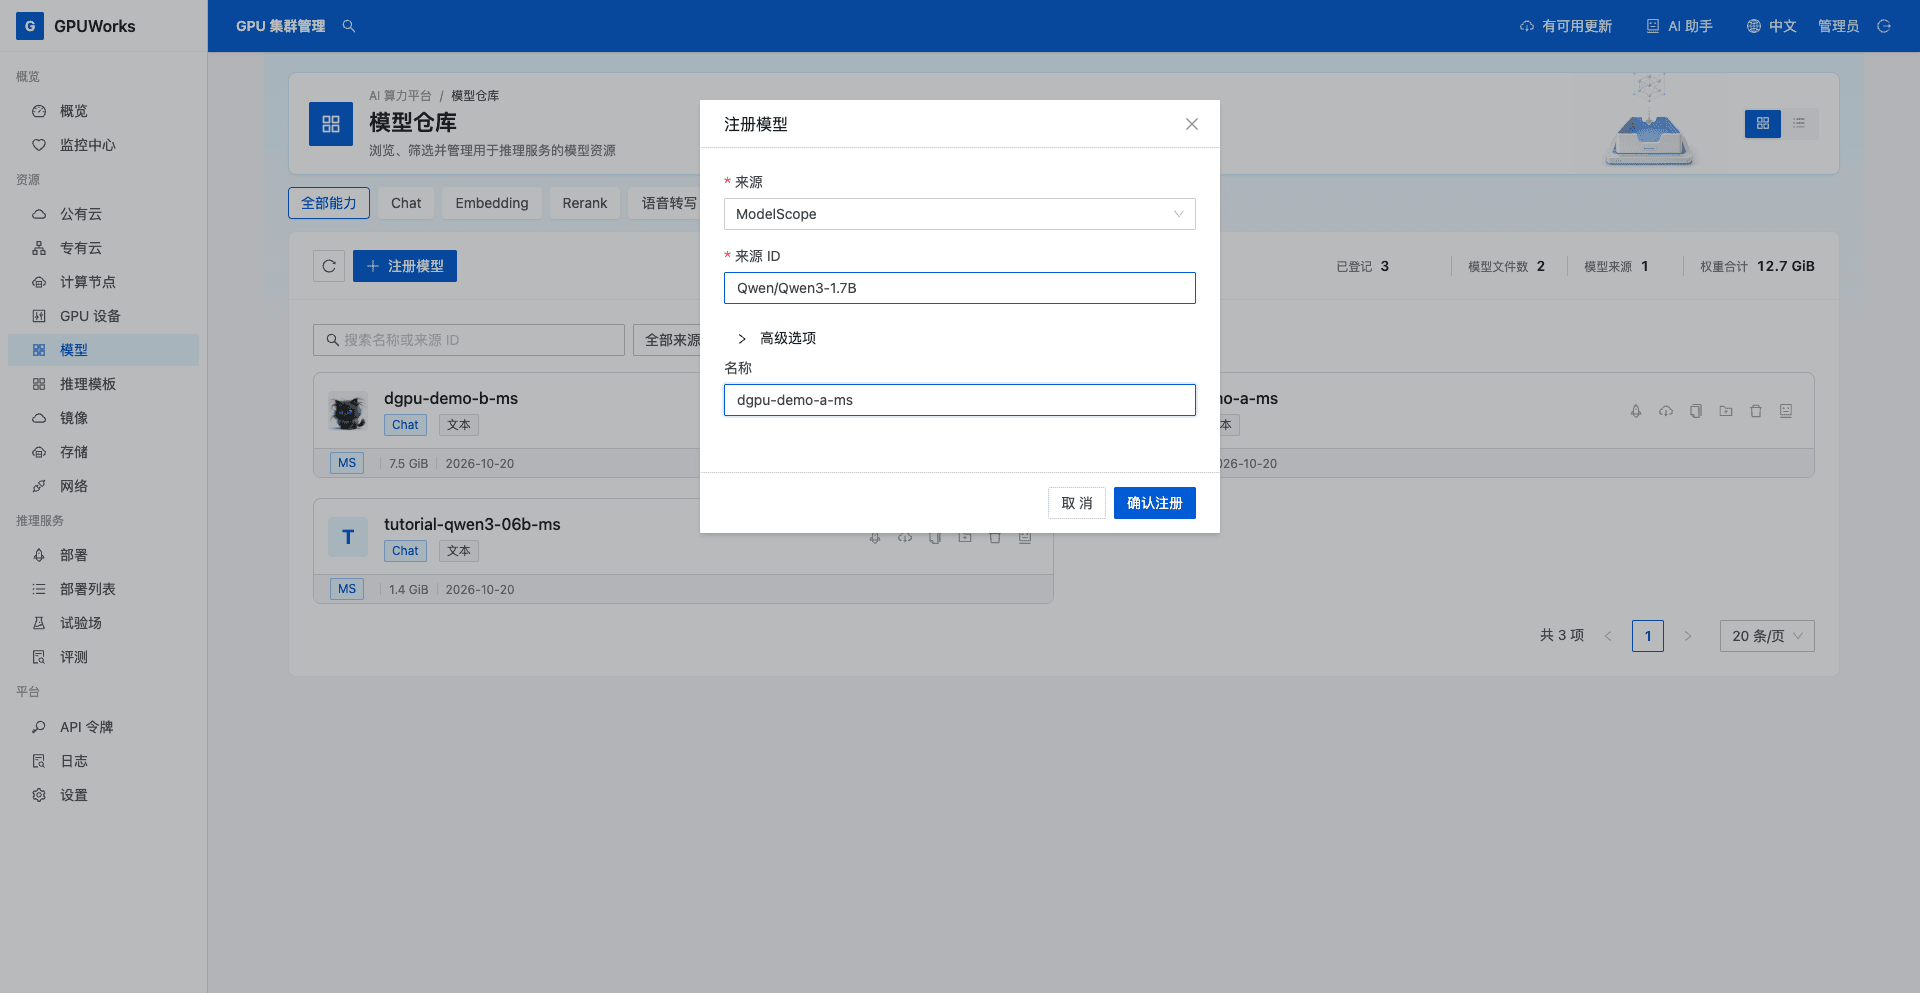
图:来源选 ModelScope,名称填 dgpu-demo-a-ms。
注册仅登记信息,权重需另行下载。dgpu-demo-a-ms 是名称示例,不会开启 dGPU;后续部署可复用此模型和 vLLM 镜像。
下载到节点
- 在
dgpu-demo-a-ms的模型卡片上点击下载到…;下载图标的提示为从模型源下载到存储。 - 存储选择节点使用的本地存储(仅有一个可写本地存储时自动选定,不显示此字段)。
- 在计算节点中仅选择
host3,点击下载。 - 点击模型名称,在详情的模型文件中找到
host3,等待下载完成、状态变为可用后再继续。 已开始下载仅表示任务已提交。
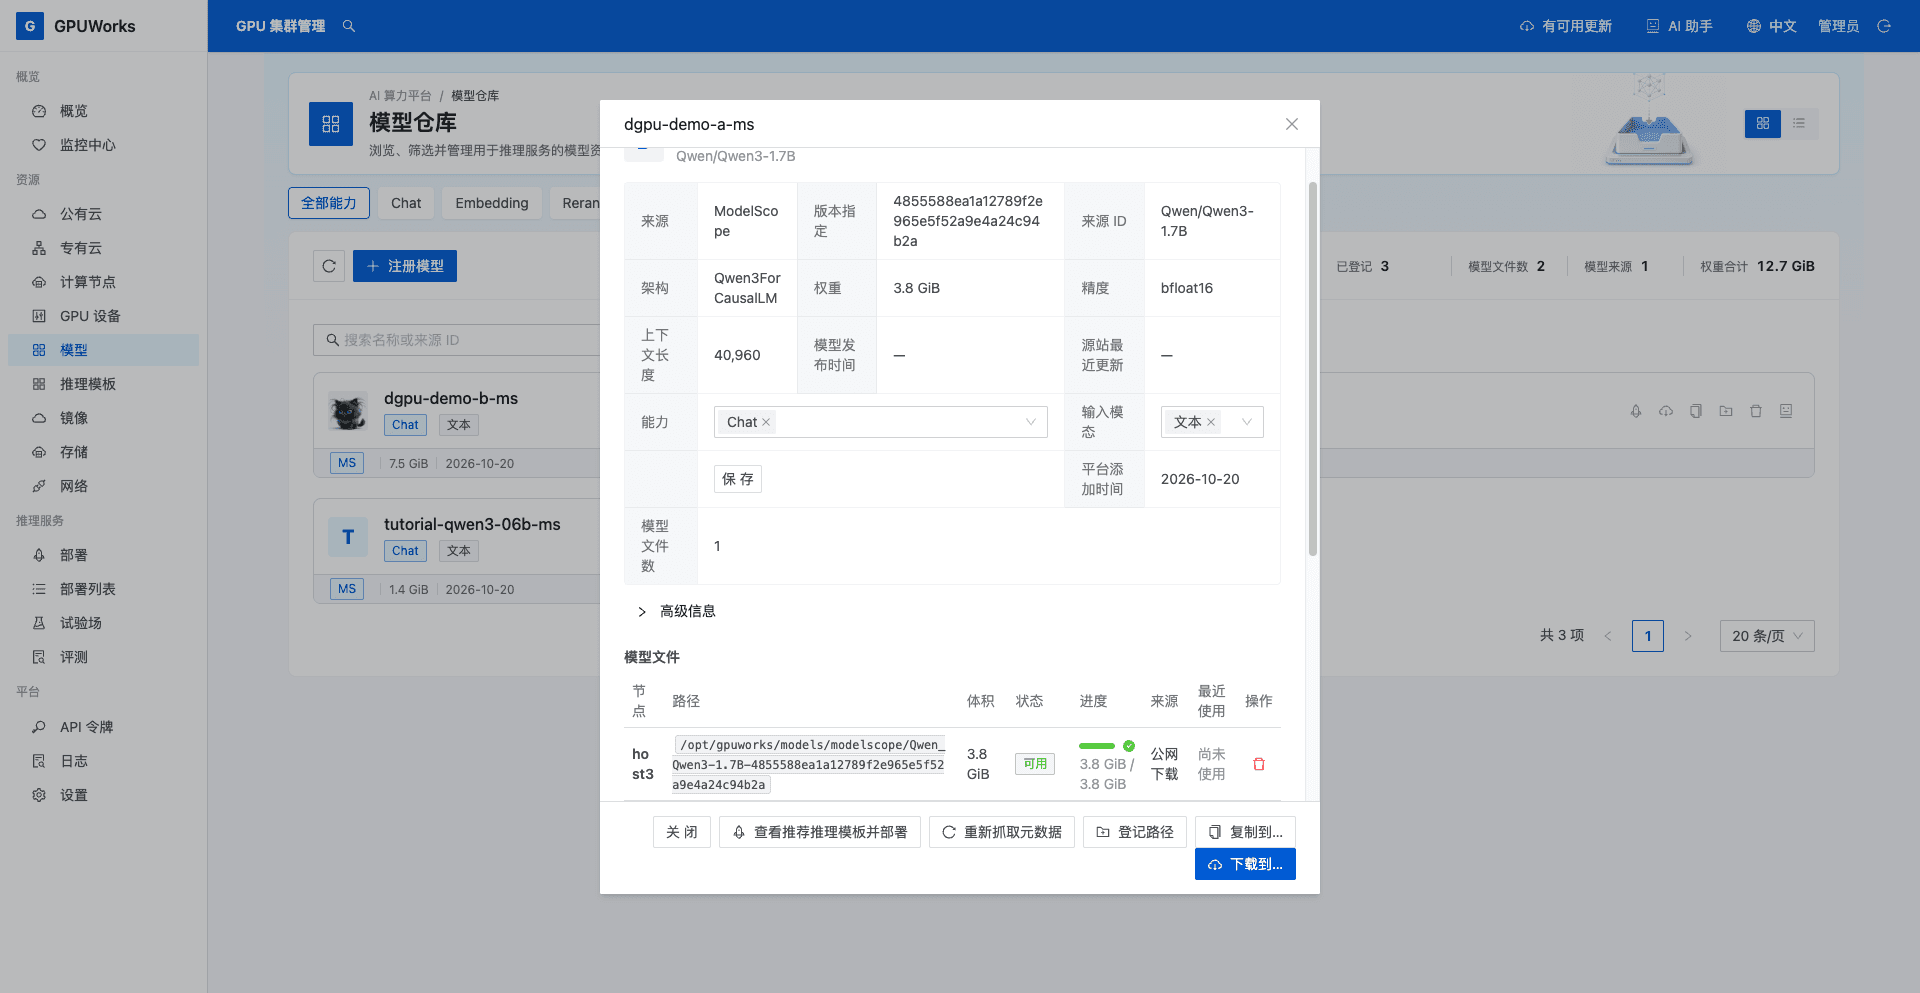
图:确认 host3 的模型文件为“可用”。
4. 创建推理令牌
- 打开左侧 API 令牌,在推理服务令牌区域点击创建推理令牌。
- 在创建 API 令牌弹窗中,名称填写
tutorial-qwen3-17b,点击创建。 - 在请立即保存 API 令牌弹窗中点击复制 API 令牌,安全保存完整值,再点击我已保存。
完成依据:列表出现 tutorial-qwen3-17b,你已保存以 gw- 开头的完整令牌。列表仅显示前缀,不能用于调用。
新装的 server 不预置任何令牌,所以这一步必须自己建:/v1 默认要求 key,在创建第一个令牌之前它拒绝所有推理请求。
gwp_ 开头的是平台 API 令牌,用于管理接口,不用于本教程。
5. 部署模型
- 打开左侧推理服务,点击创建部署,使用快捷部署。模型选择
dgpu-demo-a-ms,目标芯片选择 NVIDIA。 - 推荐推理模板选择 Qwen3-1.7B → general · vllm · balanced,镜像应为
gpuworks/gpuworks-runner:cuda13.0-vllm0.30.0-r4。 若弹出使用已登记的模型?,选择带 MS、1 个节点标记的dgpu-demo-a-ms,点击使用此模型并部署,返回后核对所选模型。 - 部署名称、对外模型名均填
tutorial-qwen3-17b;后者用于请求中的model。
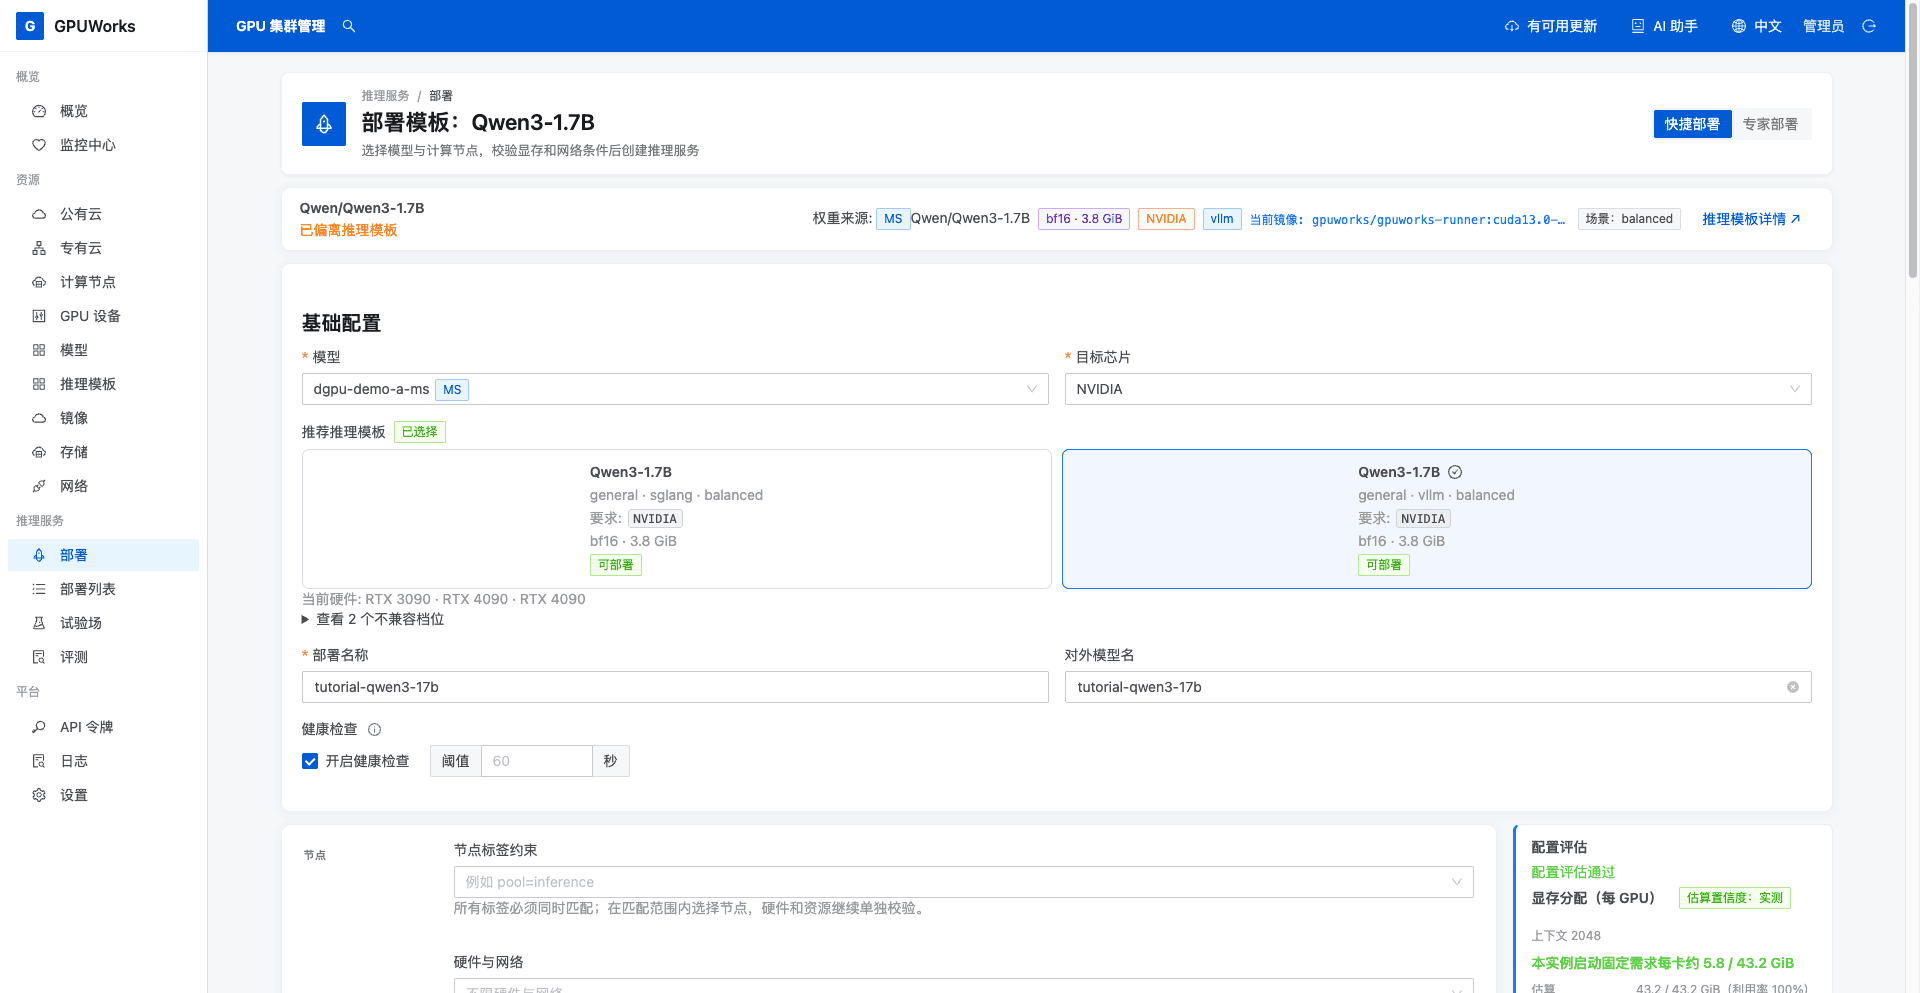
图:部署名称和对外模型名保持一致。
- 在节点区域选择单机和手动指定,选择
host3和空闲的 GPU 0,副本数保持1。 dGPU 显存(GiB)留空(使用整卡),关闭可休眠;最大上下文设为2048,显存使用率设为0.90,其余使用模板值。
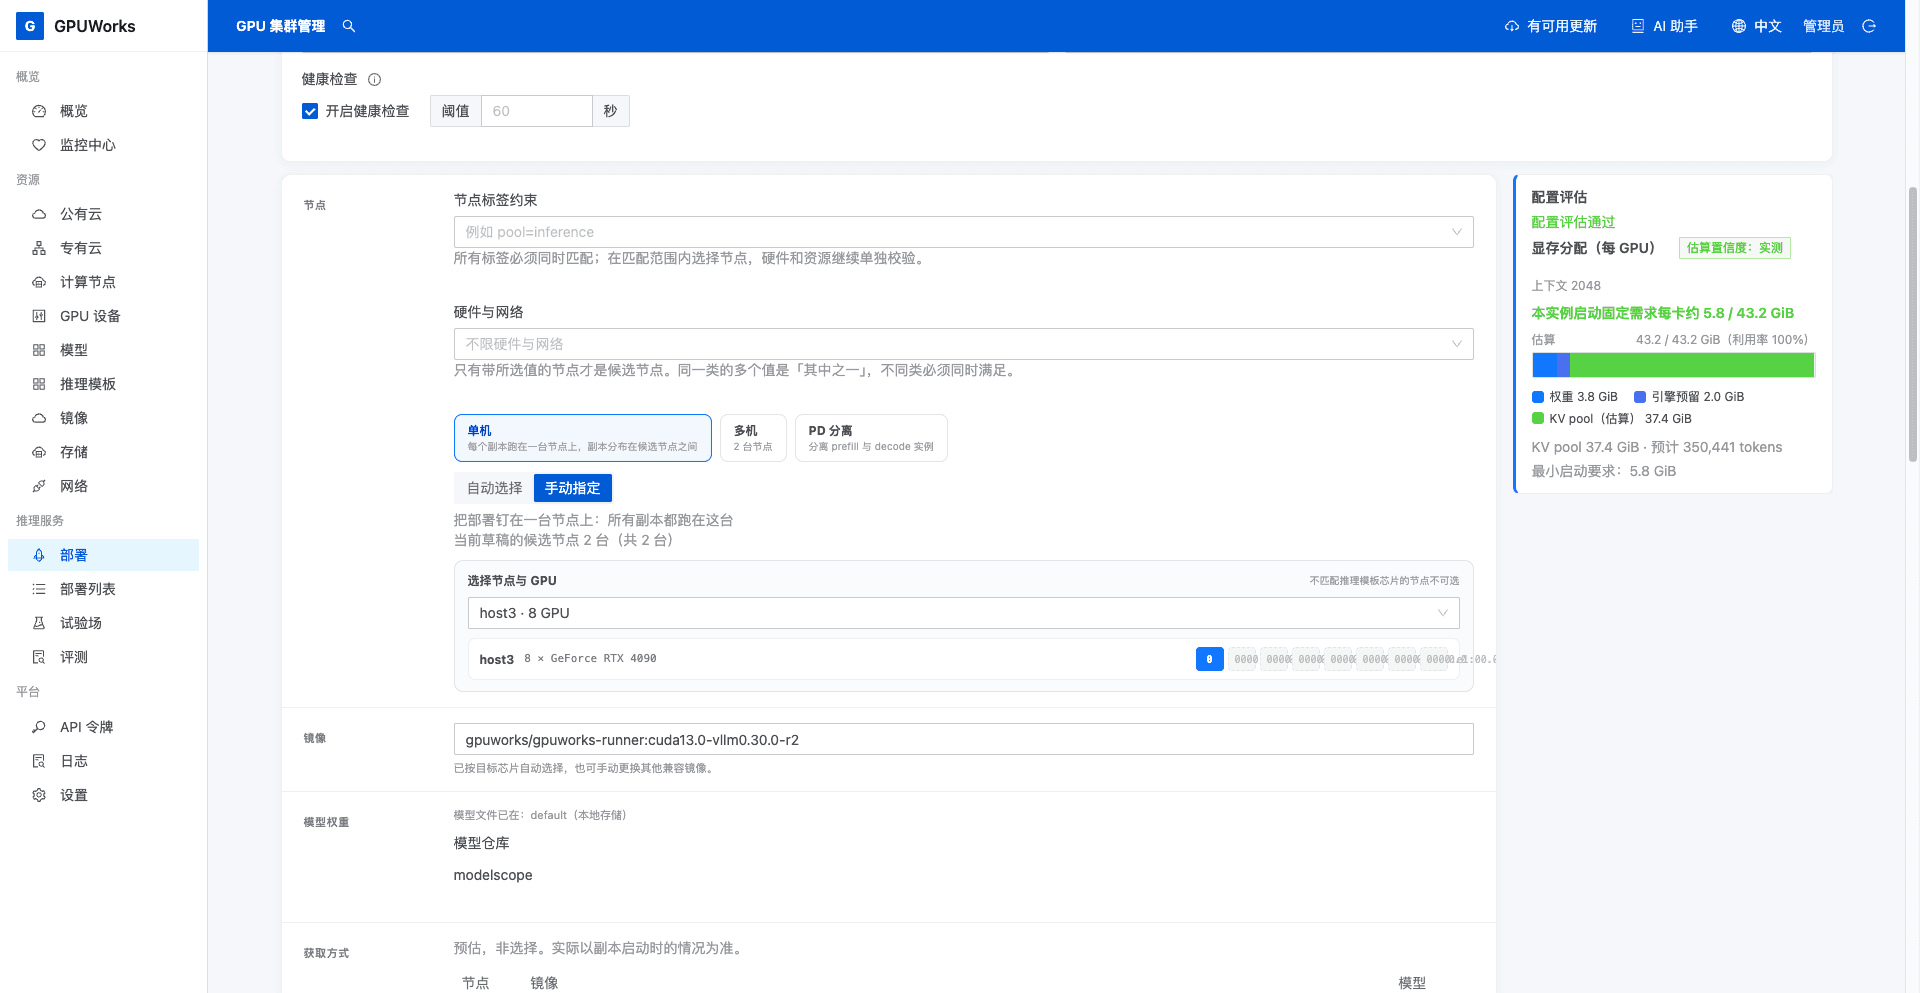
图:选中 host3 的 GPU 0,并检查右侧配置评估。
- 等待配置评估完成,核对节点、GPU、镜像和显存,确认没有阻止部署的错误。
- 点击部署,在推理服务打开
tutorial-qwen3-17b,查看模型准备、镜像拉取和实例启动进度。
完成依据:部署及实例均为运行中。首次启动需下载镜像、加载模型,请等待完成。 下一步用真实请求验证推理接口。
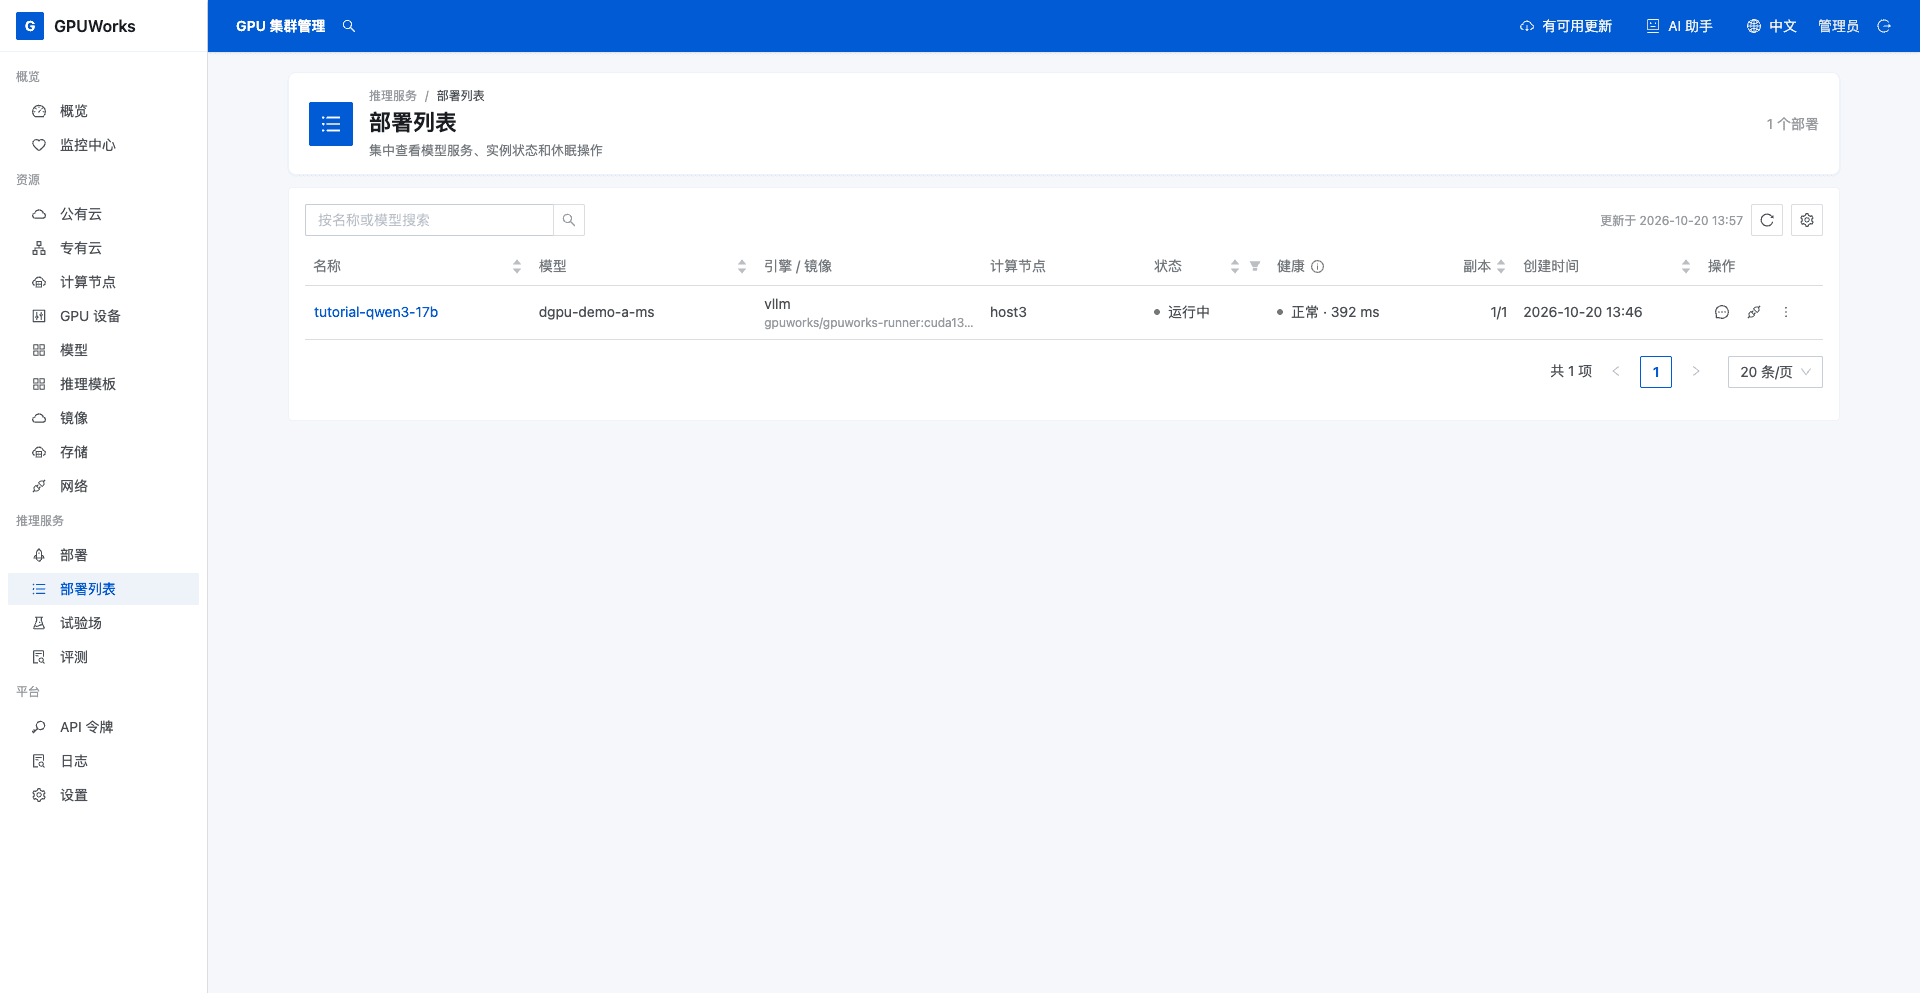
图:确认部署“运行中”、健康检查正常,副本数为 1/1。
6. 调用并验证回答
在能访问控制面的机器上打开 Bash 终端,替换 URL 后执行以下命令,按提示粘贴第 4 步的完整推理令牌(输入不回显)。
GPUWORKS_URL=http://192.0.2.10:8800
read -r -s -p '请粘贴推理令牌:' GPUWORKS_API_KEY
printf '\n'
curl -sS -w '\nHTTP %{http_code}\n' "$GPUWORKS_URL/v1/chat/completions" \
  -H "Authorization: Bearer $GPUWORKS_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{"model":"tutorial-qwen3-17b","messages":[{"role":"user","content":"请用一句话介绍你自己。"}],"max_tokens":256,"chat_template_kwargs":{"enable_thinking":false}}'
unset GPUWORKS_API_KEY
请求关闭 Qwen3 思考模式,便于检查简短回答。最终验证须同时满足:
- 命令末尾显示
HTTP 200。 - 返回 JSON 的
choices[0].message.content有回答,内容不必与示例一致。
仅有“运行中”状态或 HTTP 错误响应不能算完成。
也可在试验场 → 对话选择 tutorial-qwen3-17b,输入“请用一句话介绍你自己。”,点击发送查看回答。
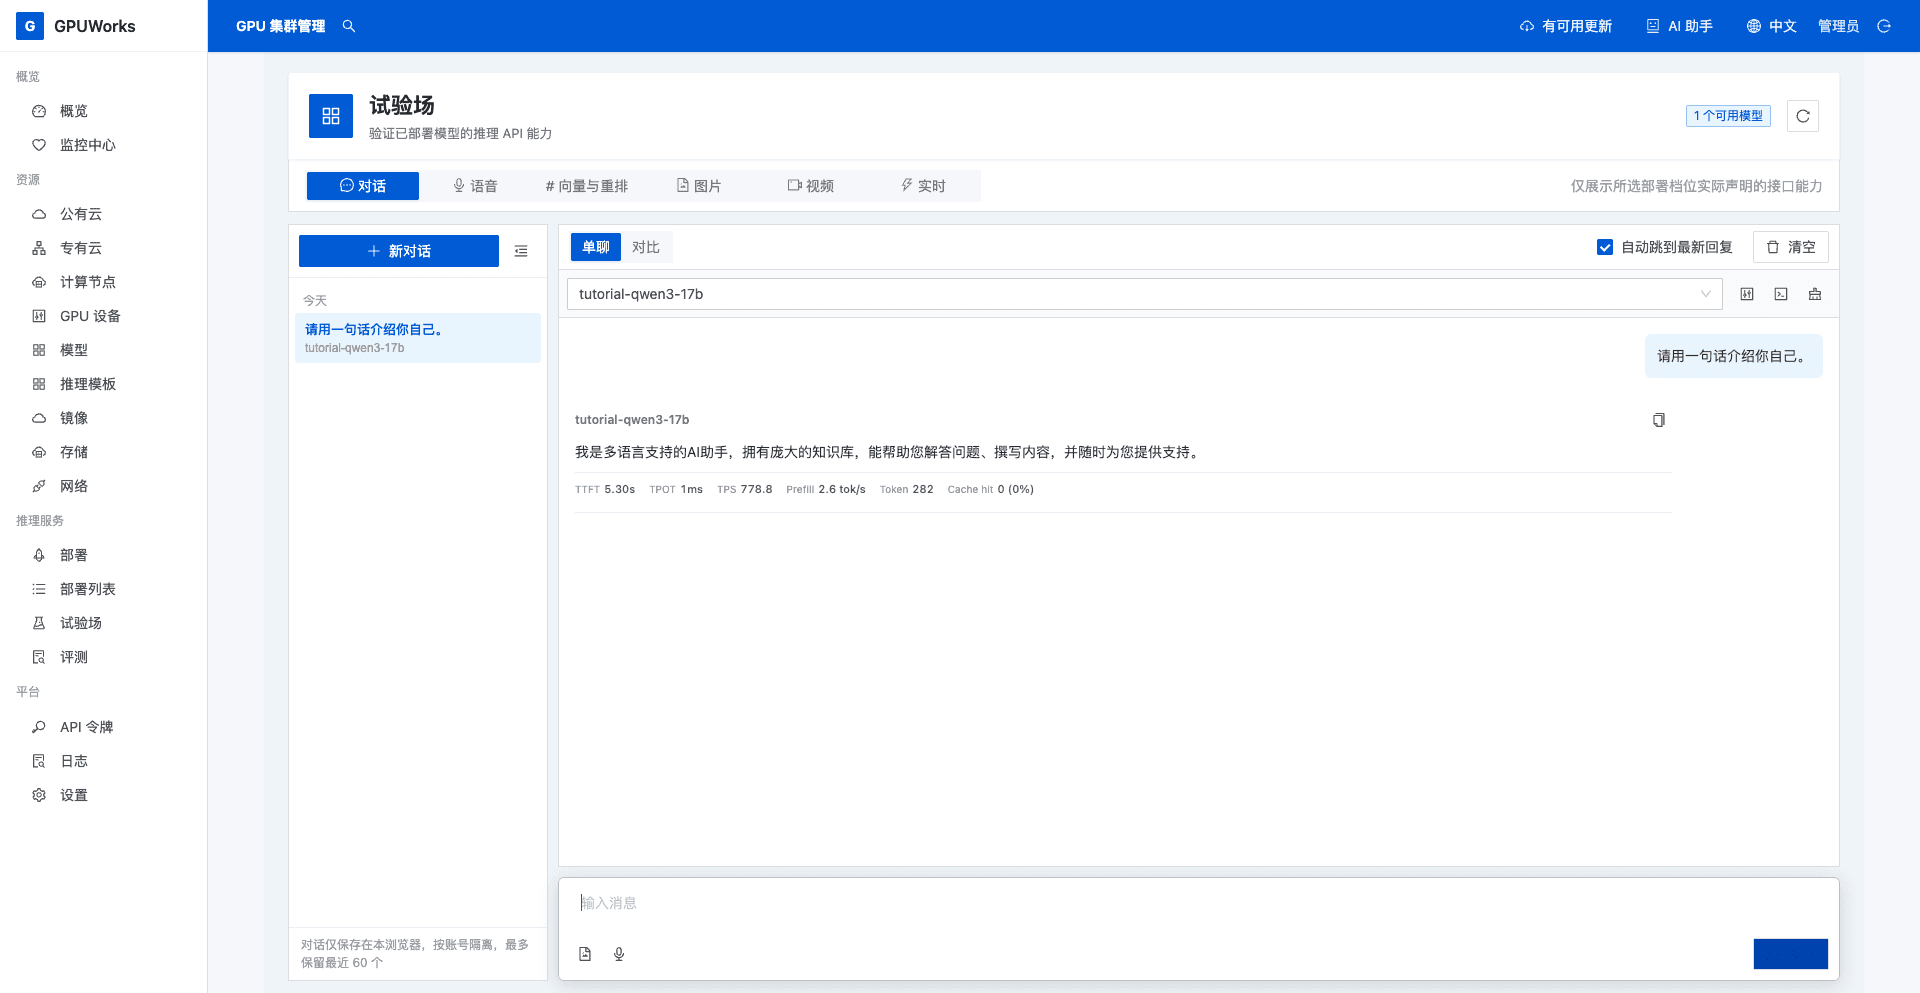
图:模型名称与部署时的对外模型名一致,下方显示本次提问的回答。
下一步
- 想在一张卡上同时跑两个模型:一张 GPU 跑两个模型
- 弄清部署表单里每一项的含义:部署模型与解释调度结果
- 了解整个控制台:控制台页面导览
- 选择合适的特性组合:怎么选:dGPU、sleep/wake、多机、副本、PD
- 上生产之前:生产环境部署
这篇文档有帮助吗?